Analisi esperta dei distacchi massivi a Dongsheng e del blackout dell'Asia centrale. Mancato coordinamento delle protezioni, meccanismi a cascata e raccomandazioni per la rete.
Riepilogo dell'incidente
Nota sulle fonti: il resoconto fattuale di questo articolo si basa su annunci pubblicati pubblicamente e report dei media; l'analisi del meccanismo riflette una logica ingegneristica generalmente applicabile in tutto il settore. Le conclusioni finali su entrambi gli eventi rimangono soggette alle indagini ufficiali.
Nel pomeriggio del 14 agosto 2026, un blackout su larga scala ha colpito il Sistema Elettrico Unificato dell'Asia Centrale. Le città di Kazakistan, Uzbekistan, Tagikistan e Kirghizistan sono state piombate nel buio, interrompendo l'alimentazione a milioni di residenti.
Alle 15:08 del 25 agosto, la protezione di massima corrente di terza soglia è intervenuta sulla linea Maliang 962 da 10 kV presso la Sottostazione Dongsheng a 110 kV in Mongolia Interna. L'interruttore ha effettuato un tentativo di richiusura automatica; il tentativo non è andato a buon fine e la linea è stata messa fuori servizio. A prima vista, si tratta solo di un guasto locale su una partenza di distribuzione, che colpisce i clienti collegati a quella singola linea.
Due eventi, a circa 2.900 km di distanza e diversi per ordine di grandezza di circa due o tre ordini di grandezza. Mettendoli a confronto, puntano entrambi alla stessa domanda fondamentale nella protezione a relè: cosa significa esattamente "coordinamento"?
I manuali insegnano come calcolare le impostazioni, come applicare il coordinamento temporale graduato e come verificare la sensibilità. Gli eventi reali non seguono mai il manuale. Uno di questi eventi si è verificato presso un interruttore esterno all'estremità di una rete di distribuzione; l'altro, su una dorsale transfrontaliera a 500 kV. Entrambi espongono la stessa vulnerabilità in modi molto diversi: un'interruzione in un singolo anello della catena di coordinamento viene amplificata dalle dimensioni della rete, e il cliente ne paga le conseguenze in termini di durata dell'interruzione.
Questa è la parte della storia che merita di essere esaminata con calma. Molte persone spiegano un intervento non selettivo con una frase vaga: "le impostazioni non erano adeguatamente coordinate", ma la catena fisica funziona così:
Il coordinamento delle protezioni è una catena di priorità. Decide chi interviene per primo.
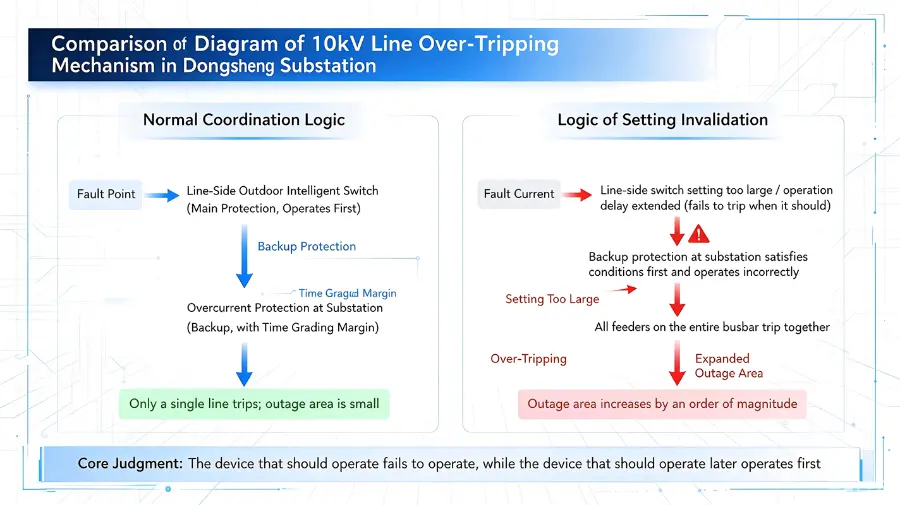
Il costo del salto di un livello di protezione non è semplicemente "intervenire un livello più a monte"; è un'espansione, potenzialmente di un ordine di grandezza, dell'area colpita. Un intervento lato linea rimuove una singola partenza. Un intervento a monte in sottostazione può rimuovere un gioco di barre e tutte le partenze da esso alimentate. In questo evento, l'interruzione è stata limitata alla singola linea, ma la logica di coordinamento era già fallita e un esito peggiore era a un solo passo di distanza.
C'è un punto tecnico qui che è facile trascurare. Gli errori di impostazione e i guasti al canale sono due tipi di problemi completamente diversi. Un guasto al canale, ovvero segnali che non passano, è un problema "visibile": il monitoraggio remoto può individuarlo. Un errore di impostazione è un problema che puoi fissare senza comunque vederlo. Le registrazioni delle forme d'onda sono normali, i messaggi sono normali, il canale è sano e il dispositivo rimane alla soglia sbagliata senza fare nulla. Ecco perché un difetto latente di impostazione è più difficile da trovare di un guasto al canale: non genera alcun allarme, semplicemente non fa nulla.
Prima: da dove provengono le impostazioni? Gli interruttori automatici intelligenti esterni sono numerosi e ampiamente dispersi. Le loro impostazioni sono spesso preconfigurate dal produttore con parametri generici e in fase di messa in servizio non viene eseguito alcun controllo di coordinamento rispetto alle protezioni all'interno della sottostazione. I valori predefiniti di fabbrica non sono impostazioni coordinate a livello di sistema; questa è la fonte primaria di impostazioni invertite.
Seconda: perché la messa in servizio e il collaudo non l'hanno rilevato? Se la messa in servizio avesse incluso un passaggio obbligatorio, la "verifica del coordinamento delle impostazioni con la protezione di sottostazione", in cui le impostazioni lato linea e quelle di sottostazione vengono inserite nella stessa tabella di confronto e i loro intervalli di tempo di coordinamento verificati, questo sarebbe stato trovato prima dell'energizzazione. Il fatto che non sia stato trovato significa che il passaggio mancava nella lista di controllo del collaudo o che è stato eseguito solo sulla carta.
Terza: perché è rimasto invisibile durante il funzionamento? Le impostazioni sono disperse tra produttori, squadre di manutenzione e centri di dispacciamento, senza un sistema unificato per la circolazione dei documenti di impostazione o per le prove periodiche. Una volta che le apparecchiature sono in servizio, "imposta una volta e non toccarle mai più" non è insolito nelle reti di distribuzione. Il fatto che le impostazioni vengano rivereficate dopo manutenzione, aggiornamenti o modifiche alle impostazioni dipende troppo spesso dalla diligenza della squadra piuttosto che da una procedura.
Tutte e tre le domande puntano alla stessa conclusione. In superficie, l'evento di Dongsheng è stato causato da un'impostazione errata. Nel suo nucleo, è stato causato da una lacuna nel sistema di gestione delle impostazioni.
L'evoluzione della versione ufficiale merita attenzione:
| Versione |
Dichiarazione |
Fonte |
| Prime segnalazioni |
Le elevate temperature estive hanno fatto aumentare la domanda e incrementato lo stress sul sistema. |
Segnalazioni dei media che citano un primo avviso di KEGOC |
| Resoconto tecnico di KEGOC |
Due unità della centrale idroelettrica di Toktogul sono andate fuori servizio (una perdita di circa 600 MW), sovraccaricando il corridoio di trasmissione Nord-Est-Sud e isolando la rete meridionale. |
KEGOC (come riportato) |
| Posizione del Kirghizistan |
Il breve arresto delle due unità di Toktogul è stato il disturbo iniziale che ha modificato i flussi di potenza e attivato l'automazione di protezione. Il sistema nazionale è passato al funzionamento in isola solo dopo un disturbo regionale, e le successive interruzioni in altri paesi richiedono un'analisi separata. |
Ministero dell'Energia della Repubblica Kirghisa |
Permangono discrepanze tra le fonti e la conclusione finale è in attesa dell'indagine ufficiale. Ma c'è un dettaglio ingegneristico che nessuna delle parti può ignorare: il funzionamento a cascata degli schemi di controllo di emergenza ha contribuito direttamente alla diffusione di questo blackout.
La filosofia progettuale degli schemi di controllo di emergenza (noti in Cina come dispositivi automatici di sicurezza) può essere riassunta in una frase: quando qualcosa fallisce, proteggere l'intera rete e sacrificare la parte locale. Agiscono come una valvola di sicurezza per la rete: quando rilevano una sezione di trasmissione sovraccarica, una frequenza anomala o un rischio di perdita di sincronismo, scaricano il carico in un ordine preimpostato per evitare il collasso della dorsale.
Questa logica è solida ed è efficace per un singolo guasto. Ma quando i guasti si accumulano e le impostazioni delle diverse sezioni non sono coordinate a livello globale, la valvola di sicurezza si trasforma in un amplificatore.
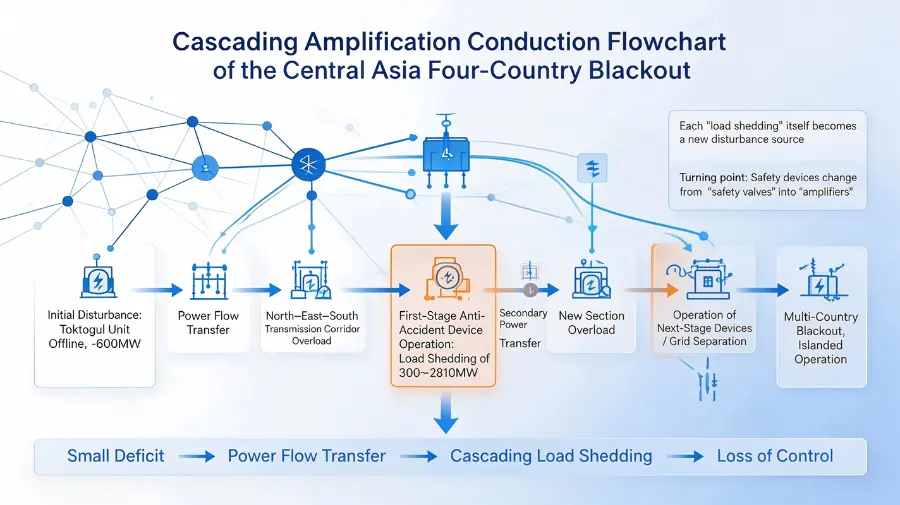
L'essenza di una cascata è che lo scarico stesso diventa una nuova perturbazione. Ogni azione di scarico del carico ridistribuisce il flusso di potenza sull'intera rete. Se il dispositivo successivo è impostato per le condizioni di peggiore caso della propria sezione, senza tenere conto dei flussi che lo scarico a monte ha spostato su di esso, può propagare il guasto a linee e sezioni che in precedenza erano sane. Un deficit di 600 MW è una piccola perturbazione in termini di capacità del sistema; eppure, attraverso la catena "sovraccarico → scarico → trasferimento di flusso → nuovo sovraccarico → nuovo scarico", può finire per interrompere l'alimentazione a milioni di clienti.
Un ulteriore dettaglio su cui riflettere: il deficit stesso di 600 MW non è stato fatale. Ciò che è stato fatale è stata l'assenza di coordinamento a livello di sistema tra i margini di capacità di trasferimento lungo il percorso di propagazione del deficit e le impostazioni dei dispositivi. Se lo scarico del carico è coordinato a livelli e per sezione, secondo il principio di minimizzare il carico totale interrotto, molte cascate possono essere arrestate già alla prima fase.
Primo: perché una piccola perturbazione può propagarsi a cascata attraverso una rete interconnessa? Una rete interconnessa transfrontaliera esiste affinché i suoi membri condividano la capacità di riserva e si supportino a vicenda. Ma ciò significa anche che una perturbazione può viaggiare indefinitamente lungo le interconnessioni. In un sistema isolato, l'intervento di una singola unità può causare nient'altro che un'escursione di frequenza; in uno interconnesso, diventa un'impennata del flusso di potenza transfrontaliero, un test del margine di coordinamento di ogni sezione e di ogni dispositivo di controllo.
Secondo: quanto deve essere ampia la visione quando si regolano le impostazioni per le cascate? Tradizionalmente, gli schemi di controllo di emergenza erano impostati per "questa centrale, questa sottostazione, questa linea". Questo evento dimostra che, a livello di un sistema elettrico integrato, devono essere impostati a livello di sistema e a livello di sezione transfrontaliera: la strategia di scarico del Paese A deve tenere conto di come cambierà i flussi di sezione nel Paese B. Per quanto precisamente vengano regolate le singole impostazioni, non si ottiene nulla se manca il coordinamento a livello di sistema.
Terzo: la segnalazione caotica degli incidenti è una questione di poco conto? Le prime segnalazioni hanno attribuito l'evento al carico dovuto alle alte temperature; il successivo resoconto tecnico ha revisionato questa causa in un intervento di un'unità idroelettrica. Per una risposta coordinata transfrontaliera, questo tipo di dietrofront è una grave interruzione: quando i centri di dispacciamento in diversi paesi eseguono studi di scenario basati su questi avvisi, qualsiasi modifica nei dati di input li costringe a rifare i loro piani da zero. La governance delle informazioni non è una questione di pubbliche relazioni, è un'infrastruttura operativa per una risposta coordinata.
| Dimensione |
Sottostazione di Dongsheng (estremità della rete di distribuzione) |
Quattro paesi dell'Asia centrale (rete principale transfrontaliera) |
| Modalità di guasto |
Sovracorrente su una singola partenza |
Intervento dell'unità più sovraccarico della sezione |
| Collegamento guasto |
Impostazioni dell'interruttore esterno invertite |
Cascata di schemi di controllo di emergenza non coordinati |
| Conseguenza diretta |
Intervento non selettivo a monte; la protezione di riserva nella sottostazione è intervenuta per prima |
Limitazioni di fornitura di circa 2.810 MW; interruzioni diffuse in diversi paesi |
| Filo conduttore |
Il dispositivo che avrebbe dovuto intervenire non lo ha fatto; quello che non avrebbe dovuto intervenire lo ha fatto |
Un'intera sezione è stata isolata quando era necessario isolare solo un segmento |
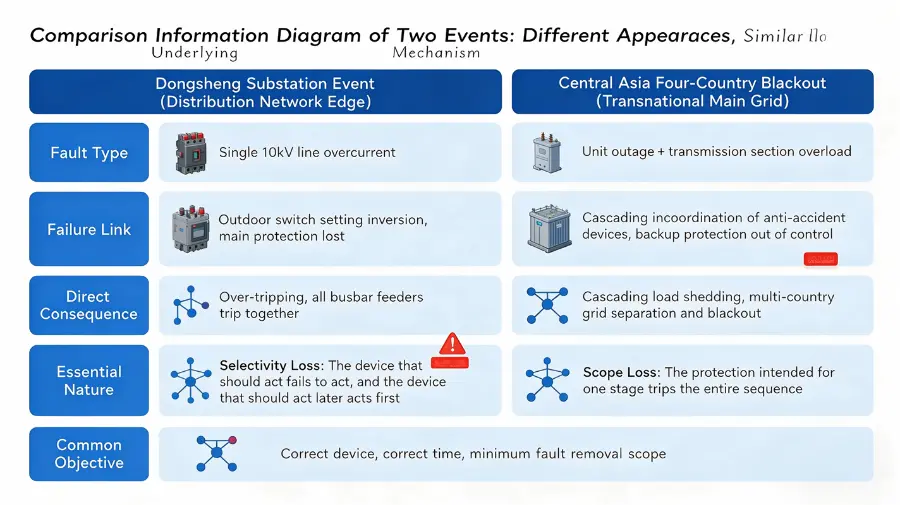
Mettendo i due casi fianco a fianco emerge una comunanza: il confine tra il funzionamento selettivo e il funzionamento di backup è stato violato.
L'intervallo di tempo di coordinamento in una rete di distribuzione è tipicamente di 0,3-0,5 s, mentre il coordinamento a incastro nelle reti principali e interconnesse varia da millisecondi a secondi. Le scale sono diverse; la matematica è la stessa. Tutto si riduce a una regola: disconnettere la parte più piccola possibile della rete, al momento giusto, con il dispositivo giusto.
Primo: un'impostazione non viene scelta "arbitrariamente", viene scelta per coordinamento. Per quanto siano precise le impostazioni di un singolo dispositivo, hanno senso solo in relazione ai dispositivi ai suoi lati. Ogni numero su un foglio di impostazione deve rispondere a una domanda nella catena di coordinamento: "Perché sono 0,3 s più veloce del dispositivo lato sorgente e 0,3 s più lento del dispositivo lato carico?" (A monte qui significa il dispositivo più vicino alla sorgente, che è impostato per intervenire più lentamente.) Le impostazioni degli interruttori esterni a Dongsheng erano numeri corretti se isolati, ma errati nel contesto.
Secondo: più la rete è grande, maggiore è il costo invisibile del coordinamento. Il coordinamento all'interno di una singola sottostazione richiede una manciata di fogli di impostazione. Il coordinamento attraverso una rete interconnessa multiregionale è una matrice multidimensionale: il limite di flusso di ogni sezione, i gradini di distacco del carico di ogni dispositivo di controllo e il coordinamento del controllo automatico della generazione (AGC) e del distacco del carico a sottofrequenza (UFLS) tra i paesi. Se una singola cella di quella matrice viene compilata in modo errato, il guasto si manifesta il giorno dell'evento come una cascata.
Il compito descritto all'inizio di questo articolo è impegnativo e lo diventerà ancora di più. Con la connessione su larga scala di fotovoltaico distribuito, sistemi di accumulo di energia e veicoli elettrici:
In altre parole: nelle reti di distribuzione con un'elevata penetrazione di nuove energie, lo stile di inversione delle impostazioni di Dongsheng è destinato a manifestarsi più spesso, e ogni occorrenza costerà di più da rintracciare. Se non si costruisce ora un sistema di gestione standardizzato, se ne pagherà il prezzo in seguito, in occasione di un evento.
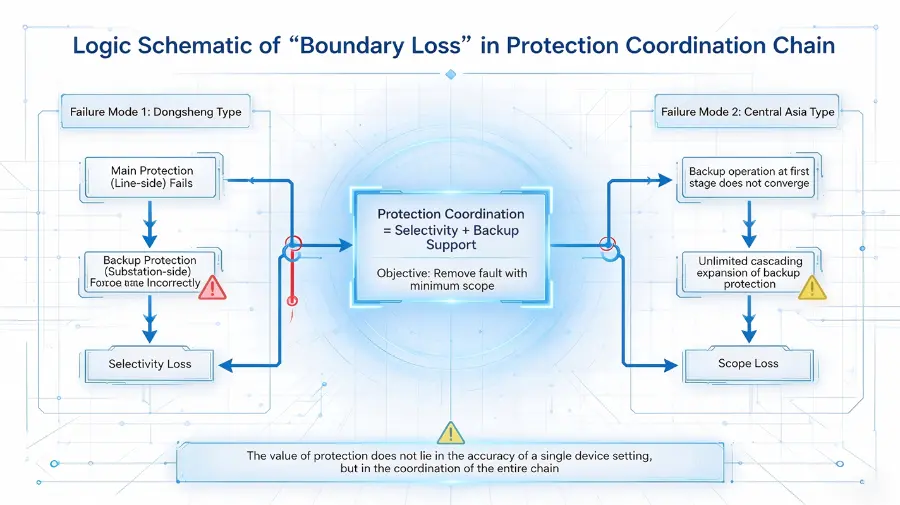
L'evento di Dongsheng e il blackout in quattro paesi dell'Asia Centrale sembrano due eventi di rete isolati: uno alla fine di una rete di distribuzione, l'altro su una dorsale transfrontaliera; uno che colpisce una singola linea, l'altro quattro paesi. Nel loro nucleo testano la stessa cosa: il coordinamento delle protezioni e la logica di controllo di emergenza possono coprire ogni interruttore, ogni linea e ogni sezione della rete?
La lezione derivata dalla pratica ingegneristica è che prevenire gli interventi non selettivi e i blackout a cascata non richiede teorie sofisticate. Ciò che richiede è:
Nulla di tutto questo è affascinante, e nulla di tutto questo finisce sui giornali. Ma giorno dopo giorno decide una cosa: quando si verifica un guasto, la rete isolerà l'area più piccola possibile e ripristinerà la fornitura più ampia possibile, oppure lascerà che un guasto minore si trasformi in un blackout di grandi dimensioni?
Con il fotovoltaico distribuito, l'accumulo di energia e i veicoli elettrici che vengono implementati su larga scala, il numero di dispositivi di protezione nelle reti di distribuzione aumenterà notevolmente e la complessità della gestione delle impostazioni non farà che crescere. Redigere il registro ora, mettere in atto i meccanismi ed eseguire scenari a cascata in simulazione sono compiti che ogni squadra in prima linea e ogni centro di dispacciamento dovrebbero iniziare il prima possibile.
Gli aggiornamenti delle apparecchiature possono attendere; i guasti no.
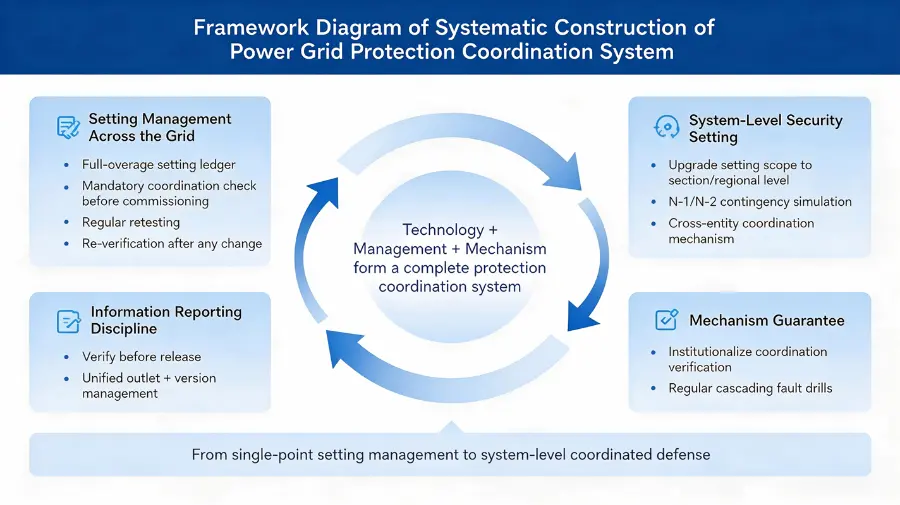
(La parte fattuale di questo articolo si basa su annunci pubblicamente disponibili e report dei media; l'analisi dei meccanismi e le raccomandazioni riflettono la logica ingegneristica di uso generale in tutto il settore e sono offerte agli operatori del settore per discussione e come riferimento. Le conclusioni finali su entrambi gli eventi rimangono soggette alle indagini ufficiali dei paesi interessati.)








 Accesso

