Analyse experte des déclenchements intempestifs de Dongsheng et du blackout en Asie centrale. Défaillances de la coordination des protections, mécanismes en cascade et recommandations pour le réseau.
Résumé des incidents
Note sur les sources : le récit factuel de cet article est basé sur des annonces publiées publiquement et des reportages médiatiques ; l'analyse du mécanisme reflète une logique d'ingénierie généralement applicable dans l'ensemble du secteur. Les conclusions finales sur ces deux événements restent soumises aux enquêtes officielles.
Dans l'après-midi du 14 août 2026, une panne d'électricité à grande échelle a frappé le système électrique unifié d'Asie centrale. Les villes du Kazakhstan, de l'Ouzbékistan, du Tadjikistan et du Kirghizistan ont été plongées dans l'obscurité, privant d'électricité des millions d'habitants.
À 15 h 08 le 25 août, la protection de surintensité du troisième seuil a fonctionné sur la ligne 962 Maliang 10 kV du poste de transformation de Dongsheng 110 kV en Mongolie intérieure. Le disjoncteur a effectué une tentative de réenclenchement automatique ; cette tentative a échoué et la ligne a été mise hors service. En apparence, il ne s'agit que d'un défaut local sur un départ de distribution, affectant uniquement les clients connectés à cette ligne.
Deux événements, séparés d'environ 2 900 km et différant en ampleur de deux à trois ordres de grandeur. Mettez-les côte à côte et ils pointent vers la même question fondamentale en protection par relais : que signifie exactement la « coordination » ?
Les manuels enseignent comment calculer les réglages, comment appliquer la coordination chronométrique et comment vérifier la sensibilité. Les événements réels ne suivent jamais les manuels. L'un de ces événements s'est produit au niveau d'un interrupteur extérieur à l'extrémité d'un réseau de distribution ; l'autre, sur une ligne dorsale transfrontalière de 500 kV. Ils exposent la même vulnérabilité de manières très différentes : une rupture d'un seul maillon de la chaîne de coordination est amplifiée par la taille du réseau, et le client en paie le prix en temps d'interruption.
C'est la partie de l'histoire qui mérite qu'on s'y attarde. Beaucoup expliquent un déclenchement non sélectif par une phrase vague — « les réglages n'étaient pas correctement coordonnés » — mais la chaîne physique se déroule ainsi :
La coordination des protections est une chaîne de priorités. Elle décide qui agit en premier.
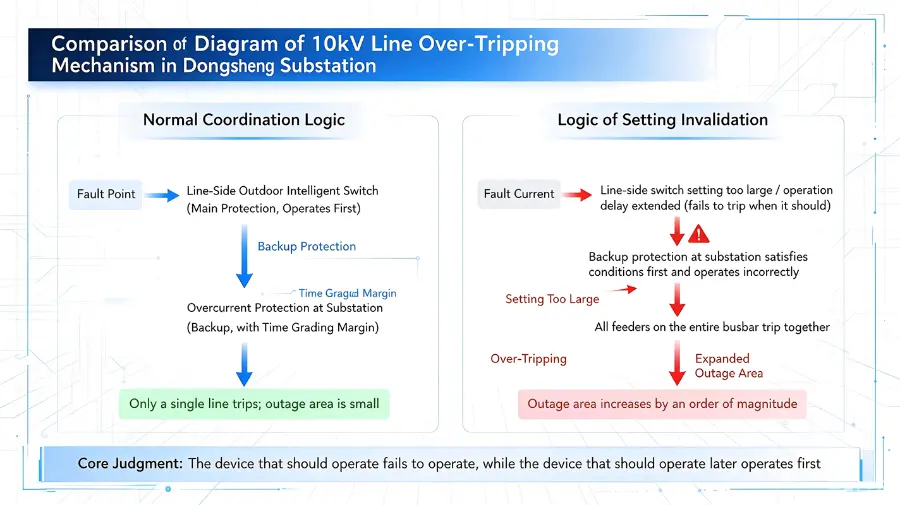
Le coût du saut d'un niveau de protection n'est pas simplement de « déclencher un niveau plus haut » ; c'est une expansion — potentiellement d'un ordre de grandeur — de la zone affectée. Un déclenchement côté ligne met hors service un départ. Un déclenchement en amont au poste peut mettre hors service une barre horizontale et tous les départs alimentés par celle-ci. Dans cet événement, la coupure s'est limitée à la seule ligne, mais la logique de coordination avait déjà échoué, et une issue pire n'était qu'à un pas.
Il y a ici un point technique facile à manquer. Les erreurs de réglage et les défauts de canal sont deux types de problèmes complètement différents. Un défaut de canal — des signaux qui ne passent pas — est un problème « visible » : la télésurveillance peut le détecter. Une erreur de réglage est un problème que vous pouvez fixer du regard sans toujours le voir. Les enregistrements des formes d'onde sont normaux, les messages sont normaux, le canal est sain, et l'appareil reste à un mauvais seuil sans rien faire. C'est pourquoi un défaut de réglage latent est plus difficile à trouver qu'un défaut de canal : il ne déclenche pas d'alarme — il ne fait tout simplement rien.
Premièrement : d'où viennent les réglages ? Les disjoncteurs intelligents extérieurs sont nombreux et largement dispersés. Leurs réglages sont souvent préconfigurés par le fabricant avec des paramètres génériques, et aucune vérification de coordination avec les protections à l'intérieur du poste n'est effectuée lors de la mise en service. Les valeurs par défaut d'usine ne sont pas des réglages coordonnés au niveau du système ; c'est la source principale des réglages inversés.
Deuxièmement : pourquoi la mise en service et la réception ne l'ont-elles pas détecté ? Si la mise en service avait inclus une étape obligatoire — « vérification de la coordination des réglages avec la protection du poste » — au cours de laquelle les réglages côté ligne et les réglages du poste sont placés dans le même tableau comparatif et leurs intervalles de temps de coordination vérifiés, cela aurait été découvert avant la mise sous tension. Le fait que cela n'ait pas été trouvé signifie que soit l'étape manquait dans la liste de contrôle de réception, soit elle n'a été effectuée que sur le papier.
Troisièmement : pourquoi est-ce resté invisible pendant l'exploitation ? Les réglages sont dispersés entre les fabricants, les équipes de maintenance et les centres de dispatching, sans système unifié pour la circulation des documents de réglage ou pour les nouveaux essais périodiques. Une fois l'équipement en service, « réglé une fois et plus jamais touché » n'est pas inhabituel dans les réseaux de distribution. Le fait que les réglages soient revérifiés après la maintenance, les mises à niveau ou les modifications de réglage dépend trop souvent de la diligence de l'équipe plutôt que d'une procédure.
Les trois questions pointent vers la même conclusion. En surface, l'incident de Dongsheng a été causé par un réglage incorrect. Au fond, il a été causé par une lacune dans le système de gestion des réglages.
L'évolution de la version officielle des faits mérite d'être soulignée :
| Version |
Déclaration |
Source |
| Rapports préliminaires |
Les températures élevées de l'été ont fait grimper la demande et accru la pression sur le système. |
Rapports des médias citant un avis préliminaire de KEGOC |
| Compte rendu technique de KEGOC |
Deux groupes de la centrale hydroélectrique de Toktogul ont été déconnectés (une perte d'environ 600 MW), surchargeant le corridor de transport Nord-Est-Sud et isolant le réseau sud. |
KEGOC (tel que rapporté) |
| Position du Kirghizistan |
La mise hors service temporaire des deux groupes de Toktogul a été la perturbation initiale qui a modifié les flux de puissance et déclenché les protections automatiques. Le système propre au pays n'est passé en mode îloté qu'après une perturbation régionale, et les pannes ultérieures dans d'autres pays nécessitent une analyse distincte. |
Ministère de l'Énergie de la République kirghize |
Des divergences entre les sources subsistent, et la conclusion finale est en attente de l'enquête officielle. Mais il y a un détail technique qu'aucune des parties ne peut ignorer : le fonctionnement en cascade des schémas de commande d'urgence a contribué directement à la propagation de cette panne.
La philosophie de conception des schémas de commande d'urgence (connus en Chine sous le nom de dispositifs automatiques de sécurité) peut se résumer en une phrase : lorsqu'un élément tombe en panne, protéger le réseau dans son ensemble et sacrifier la partie locale. Ils agissent comme une soupape de sécurité pour le réseau : lorsqu'ils détectent une section de transport surchargée, une fréquence anormale ou un risque de perte de synchronisme, ils procèdent à un délestage selon un ordre prédéfini afin d'éviter l'effondrement du réseau principal.
Cette logique est saine et s'avère efficace pour un défaut unique. Mais lorsque les défauts s'accumulent et que les réglages des différentes sections ne sont pas coordonnés à l'échelle globale, la soupape de sécurité se transforme en amplificateur.
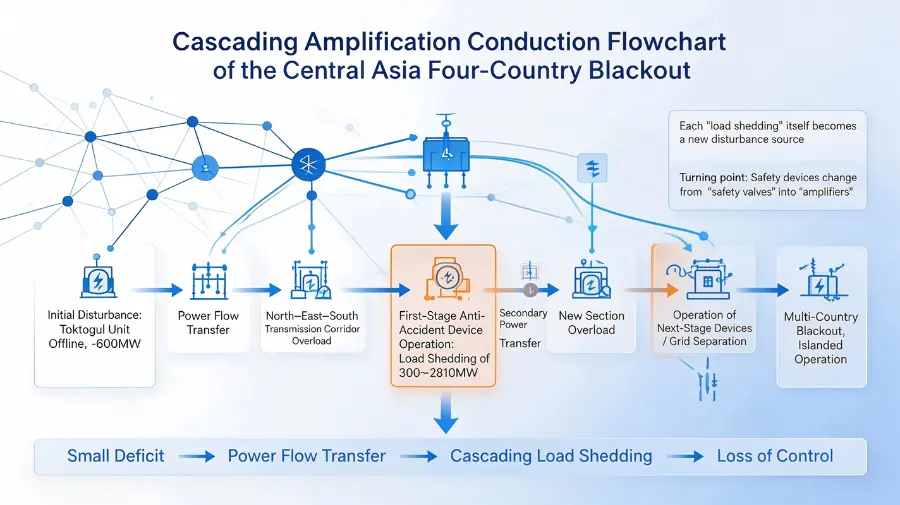
L'essence d'une cascade réside dans le fait que le délestage lui-même devient une nouvelle perturbation. Chaque action de délestage redistribue les flux de puissance à travers l'ensemble du réseau. Si le dispositif suivant est réglé pour les pires conditions de sa propre section, sans tenir compte des flux que le délestage en amont a transférés vers lui, il peut propager le défaut à des lignes et des sections qui étaient auparavant saines. Un déficit de 600 MW constitue une perturbation mineure en termes de capacité du système ; pourtant, à travers la chaîne « surcharge → délestage → transfert de flux → nouvelle surcharge → nouveau délestage », il peut finir par couper l'alimentation de millions de clients.
Un autre détail mérite réflexion : le déficit de 600 MW en lui-même n'était pas fatal. Ce qui l'était, c'était l'absence de coordination au niveau du système entre les marges de capacité de transfert le long du chemin de propagation du déficit et les réglages des dispositifs. Si le délestage est coordonné par niveaux et par section, selon le principe de minimisation de la charge totale interrompue, de nombreuses cascades peuvent être stoppées dès le premier stade.
Premièrement : pourquoi une petite perturbation peut-elle se propager en cascade à travers un réseau interconnecté ? Un réseau interconnecté transfrontalier existe pour que ses membres partagent leur capacité de réserve et se soutiennent mutuellement. Mais cela signifie également qu'une perturbation peut voyager indéfiniment le long des interconnexions. Dans un système insulaire, le déclenchement d'un seul groupe peut ne provoquer qu'un simple écart de fréquence ; dans un système interconnecté, il devient une vague de flux de puissance transfrontaliers — un test de la marge de coordination de chaque section et de chaque dispositif de commande.
Deuxièmement : quelle doit être l'ampleur de la vision lors du réglage pour les cascades ? Traditionnellement, les schémas de commande d'urgence étaient réglés pour « cette centrale, ce poste, cette ligne ». Cet événement montre qu'au niveau d'un système électrique intégré, ils doivent être réglés au niveau du système et au niveau des sections transfrontalières : la stratégie de délestage du pays A doit tenir compte de la manière dont elle modifiera les flux de section dans le pays B. Aussi précisément que les réglages individuels soient ajustés, rien n'est gagné si la coordination au niveau du système fait défaut.
Troisièmement : la communication chaotique sur les incidents est-elle une question mineure ? Les premiers rapports ont attribué l'événement à la charge due aux températures élevées ; le compte rendu technique ultérieur a révisé cela en le qualifiant de déclenchement d'un groupe hydroélectrique. Pour une réponse coordonnée transfrontalière, ce genre de revirement est une perturbation grave : lorsque les centres de dispatching de différents pays réalisent des études de scénarios sur la base de ces avis, tout changement dans les données d'entrée les oblige à refaire leurs plans à partir de zéro. La gouvernance de l'information n'est pas une question de relations publiques — c'est une infrastructure opérationnelle pour une réponse coordonnée.
| Dimension |
Sous-station de Dongsheng (extrémité du réseau de distribution) |
Quatre pays d'Asie centrale (réseau principal transfrontalier) |
| Mode de défaillance |
Surintensité sur un seul départ |
Déclenchement d'une unité et surcharge d'une section |
| Maillon ayant subi la défaillance |
Réglages de l'interrupteur extérieur inversés |
Cascade de schémas de contrôle d'urgence non coordonnés |
| Conséquence directe |
Déclenchement amont non sélectif ; la protection de secours de la sous-station a fonctionné en premier |
Restrictions d'approvisionnement d'environ 2 810 MW ; coupures généralisées dans plusieurs pays |
| Point commun |
Le dispositif qui aurait dû fonctionner ne l'a pas fait ; celui qui n'aurait pas dû fonctionner l'a fait |
Une section entière a été isolée alors qu'un seul segment devait l'être |
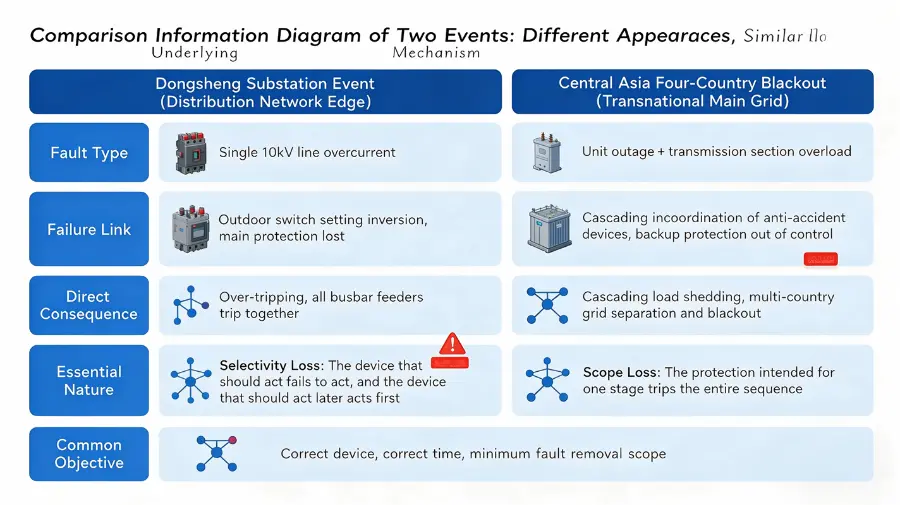
Si l'on met les deux cas côte à côte, une similitude apparaît : la frontière entre le fonctionnement sélectif et le fonctionnement de secours a été franchie.
L'intervalle de temps de coordination dans un réseau de distribution est généralement de 0,3 à 0,5 s, tandis que la coordination par verrouillage dans les réseaux principaux et interconnectés s'étend de la milliseconde à la seconde. Les échelles diffèrent ; les mathématiques sont les mêmes. Tout se résume à une seule règle : déconnecter la plus petite partie possible du réseau, au bon moment, avec le bon dispositif.
Premièrement : un réglage n'est pas choisi « arbitrairement » — il est choisi par coordination. Aussi précis que soient les réglages d'un dispositif individuel, ils n'ont de sens que par rapport aux dispositifs situés de part et d'autre. Chaque chiffre sur une fiche de réglage doit répondre à une question dans la chaîne de coordination : « Pourquoi suis-je 0,3 s plus rapide que le dispositif côté source et 0,3 s plus lent que le dispositif côté charge ? » (En amont, cela signifie ici le dispositif le plus proche de la source, qui est réglé pour fonctionner plus lentement.) Les réglages des interrupteurs extérieurs à Dongsheng étaient des chiffres corrects isolément, mais erronés dans leur contexte.
Deuxièmement : plus le réseau est grand, plus le coût invisible de la coordination est élevé. La coordination au sein d'une seule sous-station représente une poignée de fiches de réglage. La coordination à travers un réseau interconnecté multi-régional est une matrice multidimensionnelle : la limite de flux de chaque section, les étapes de délestage de chaque dispositif de contrôle, et la coordination du réglage automatique de la production (AGC) et du délestage sous-fréquence (UFLS) entre les pays. Si une seule cellule de cette matrice est mal remplie, la défaillance se manifeste le jour de l'événement sous la forme d'une cascade.
La tâche décrite au début de cet article est exigeante, et elle le deviendra encore plus. À mesure que le photovoltaïque distribué, le stockage d'énergie et les véhicules électriques sont connectés à grande échelle :
En d'autres termes : dans les réseaux de distribution à forte pénétration de nouvelles énergies, le style d'inversion de réglage de Dongsheng est appelé à apparaître plus fréquemment, et chaque occurrence coûtera plus cher à retracer. Si un système de gestion normalisé n'est pas mis en place maintenant, le prix en sera payé plus tard, lors d'un incident.
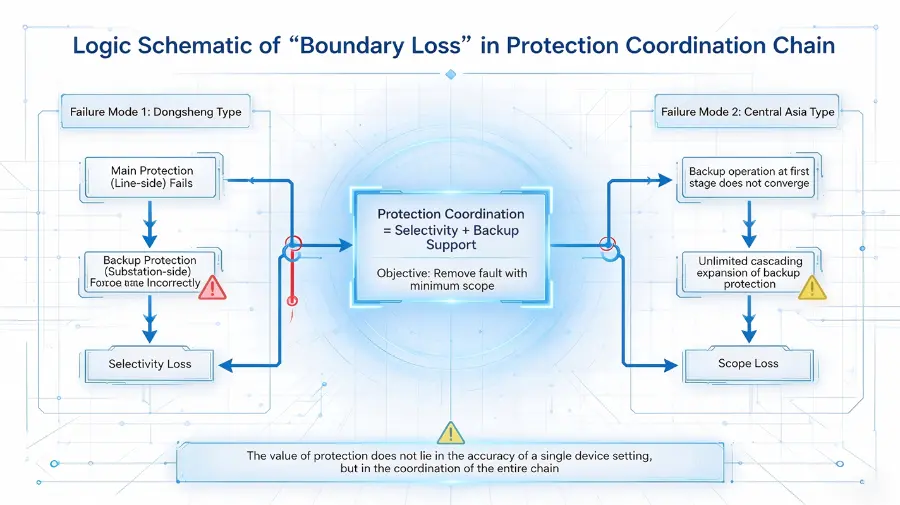
L'événement de Dongsheng et la panne de courant à travers quatre pays d'Asie centrale ressemblent à deux événements de réseau isolés — l'un à l'extrémité d'un réseau de distribution, l'autre sur un réseau de transport transfrontalier ; l'un affectant un seul départ, l'autre quatre pays. Au fond, ils testent la même chose : la coordination des protections et la logique de contrôle d'urgence peuvent-elles couvrir chaque interrupteur, chaque ligne et chaque section du réseau ?
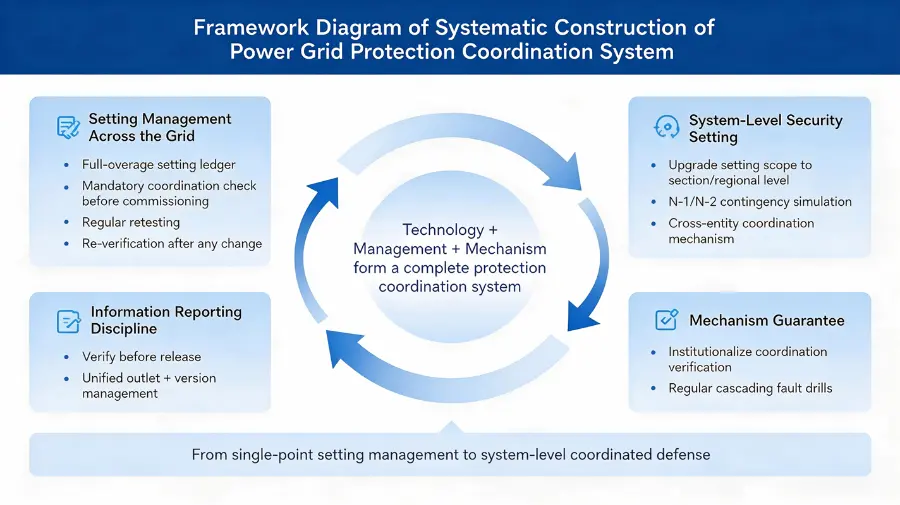
La leçon tirée de la pratique de l'ingénierie est que la prévention des déclenchements non sélectifs et des pannes en cascade ne nécessite aucune théorie sophistiquée. Ce qu'elle exige, c'est :
Ces tâches n'ont rien de spectaculaire et ne font pas la une des journaux. Pourtant, jour après jour, elles déterminent une chose essentielle : lorsqu'un défaut survient, le réseau isolera-t-il la plus petite zone possible et rétablira-t-il l'alimentation la plus large possible, ou laissera-t-il un défaut mineur dégénérer en un blackout majeur ?
Avec le déploiement à grande échelle du photovoltaïque distribué, du stockage d'énergie et des véhicules électriques, le nombre de dispositifs de protection dans les réseaux de distribution va se multiplier, et la complexité de la gestion des réglages ne fera qu'augmenter. Établir le registre dès maintenant, mettre en place les mécanismes et exécuter des scénarios de défaillances en cascade en simulation sont des tâches que chaque équipe de terrain et chaque centre de répartition devraient entreprendre dès que possible.
La modernisation des équipements peut attendre ; les défauts, non.
(La partie factuelle de cet article est basée sur des annonces publiques et des reportages médiatiques ; l'analyse des mécanismes et les recommandations reflètent la logique d'ingénierie d'usage courant dans l'industrie, et sont proposées aux professionnels pour discussion et à titre de référence. Les conclusions finales sur les deux événements restent soumises aux enquêtes officielles des pays concernés.)








 Connexion

